

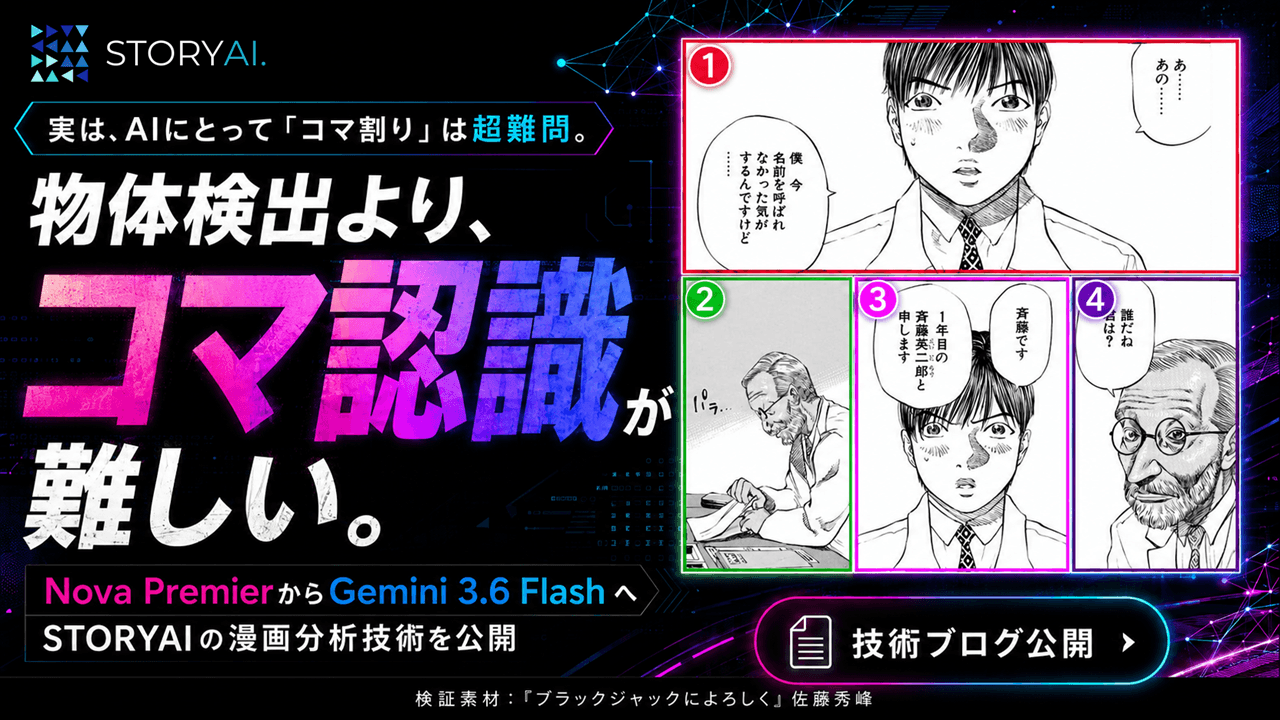
物体検出とはまったく違う、漫画固有の「境界線認識」という難題
STORYAIには、これまであまり表に出してこなかった機能があります。
それが、漫画を解析するためのシステムです。
STORYAIにとって漫画は、単なる「画像」ではありません。
1枚のページの中には複数のコマがあり、それぞれに人物、背景、吹き出し、セリフがあります。そして、それらには漫画として読むための順序があります。
人間であれば、漫画のページを見た瞬間に「ここからここまでが1コマ」「次は右上から左へ」と、ほとんど無意識に理解できます。
ところが、これをAIに認識させようとすると、一気に難易度が上がります。
今月末に予定しているSTORYAIのアップデートでは、この漫画分析部分にも大きな変更を加えます。
これまで、この処理を実用レベルで成立させられていたモデルがAmazon Nova Premierでした。
しかし、Amazon Bedrockでは Nova PremierがLegacyモデルとなり、2026年9月14日にモデル終了を迎える予定です。
そこで今回、STORYAIでは漫画解析システムそのものを再検証し、Gemini 3.6 Flashへの移行を行いました。
今回は、その裏側について少し詳しく紹介します。
漫画解析で一番難しいのは「何が描かれているか」ではない
画像解析AIというと、「この写真に犬がいる」「ここに人間がいる」といった物体検出を想像する方が多いと思います。
動画であれば、人物や車などを検出し、フレーム間で位置の変化を追うことで動態分析することもできます。
漫画の解析は、それとはかなり性質が異なります。
STORYAIが最初に理解しなければならないのは、
「このページのどこからどこまでが一つのコマなのか」
という、漫画そのものの構造です。
漫画のコマは「物体」ではありません。
四角い枠線が綺麗に描かれていることもあれば、枠線が途中で途切れていたり、黒い背景と一体化していたり、人物や吹き出しがコマをまたいでいたりします。
縦長のコマ、横長のコマ、極端に小さいコマ、ページいっぱいを使用するコマ、斜めに切られたコマもあります。
さらに、隣接する二つのコマを一つとして認識してしまう「結合」や、一つのコマを複数に分割してしまう「分裂」が起きると、その後の解析全体が崩れます。
人物認識が多少ずれることとは意味が違います。
入口でコマを間違えると、その後に解析する人物、セリフ、シーン、読む順番まですべてがずれてしまうからです。
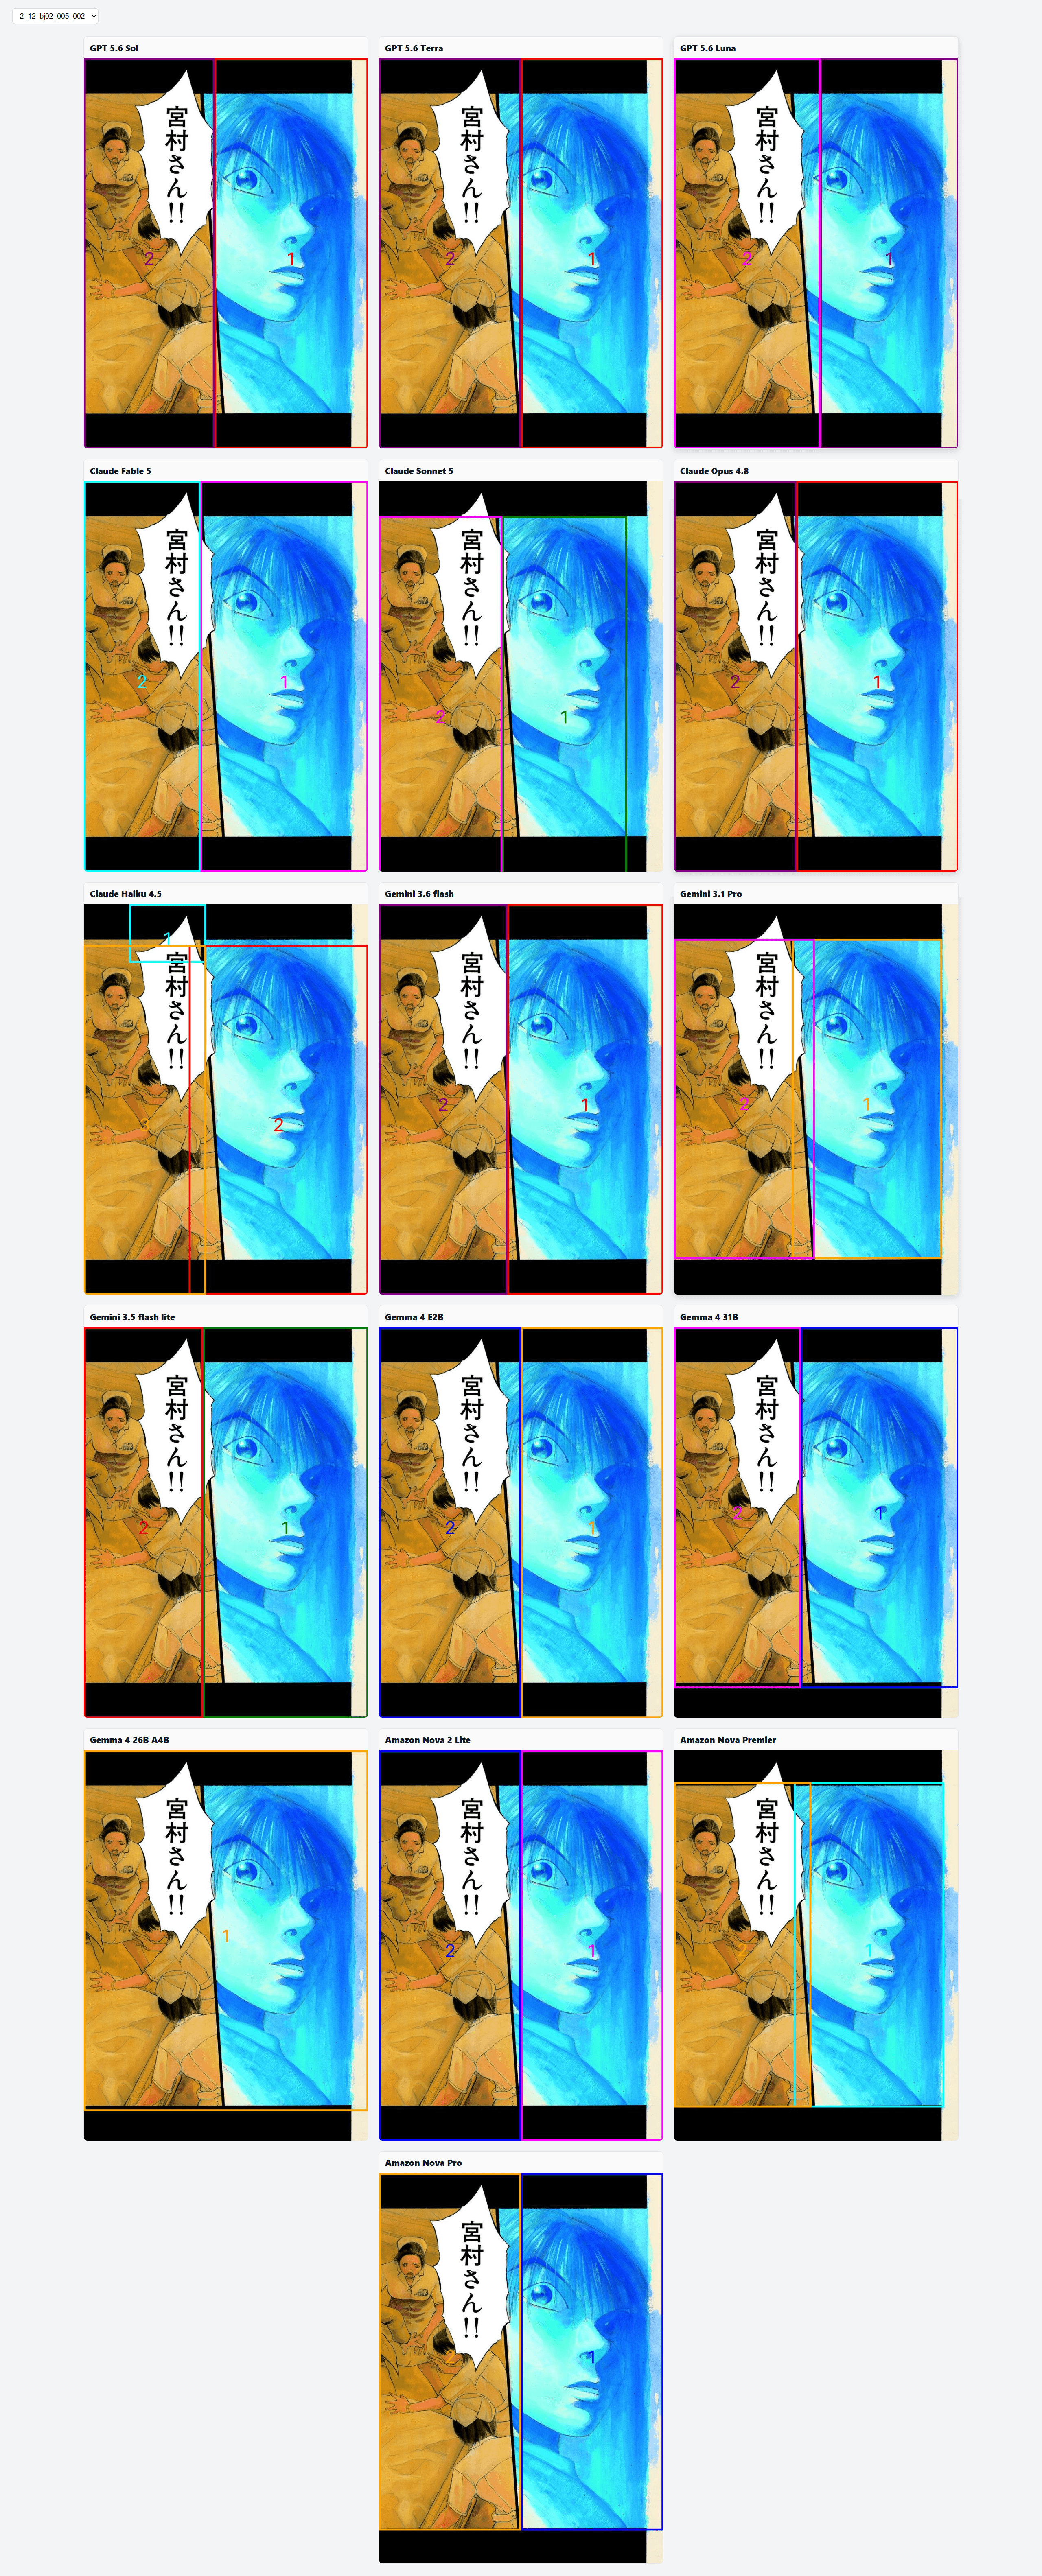
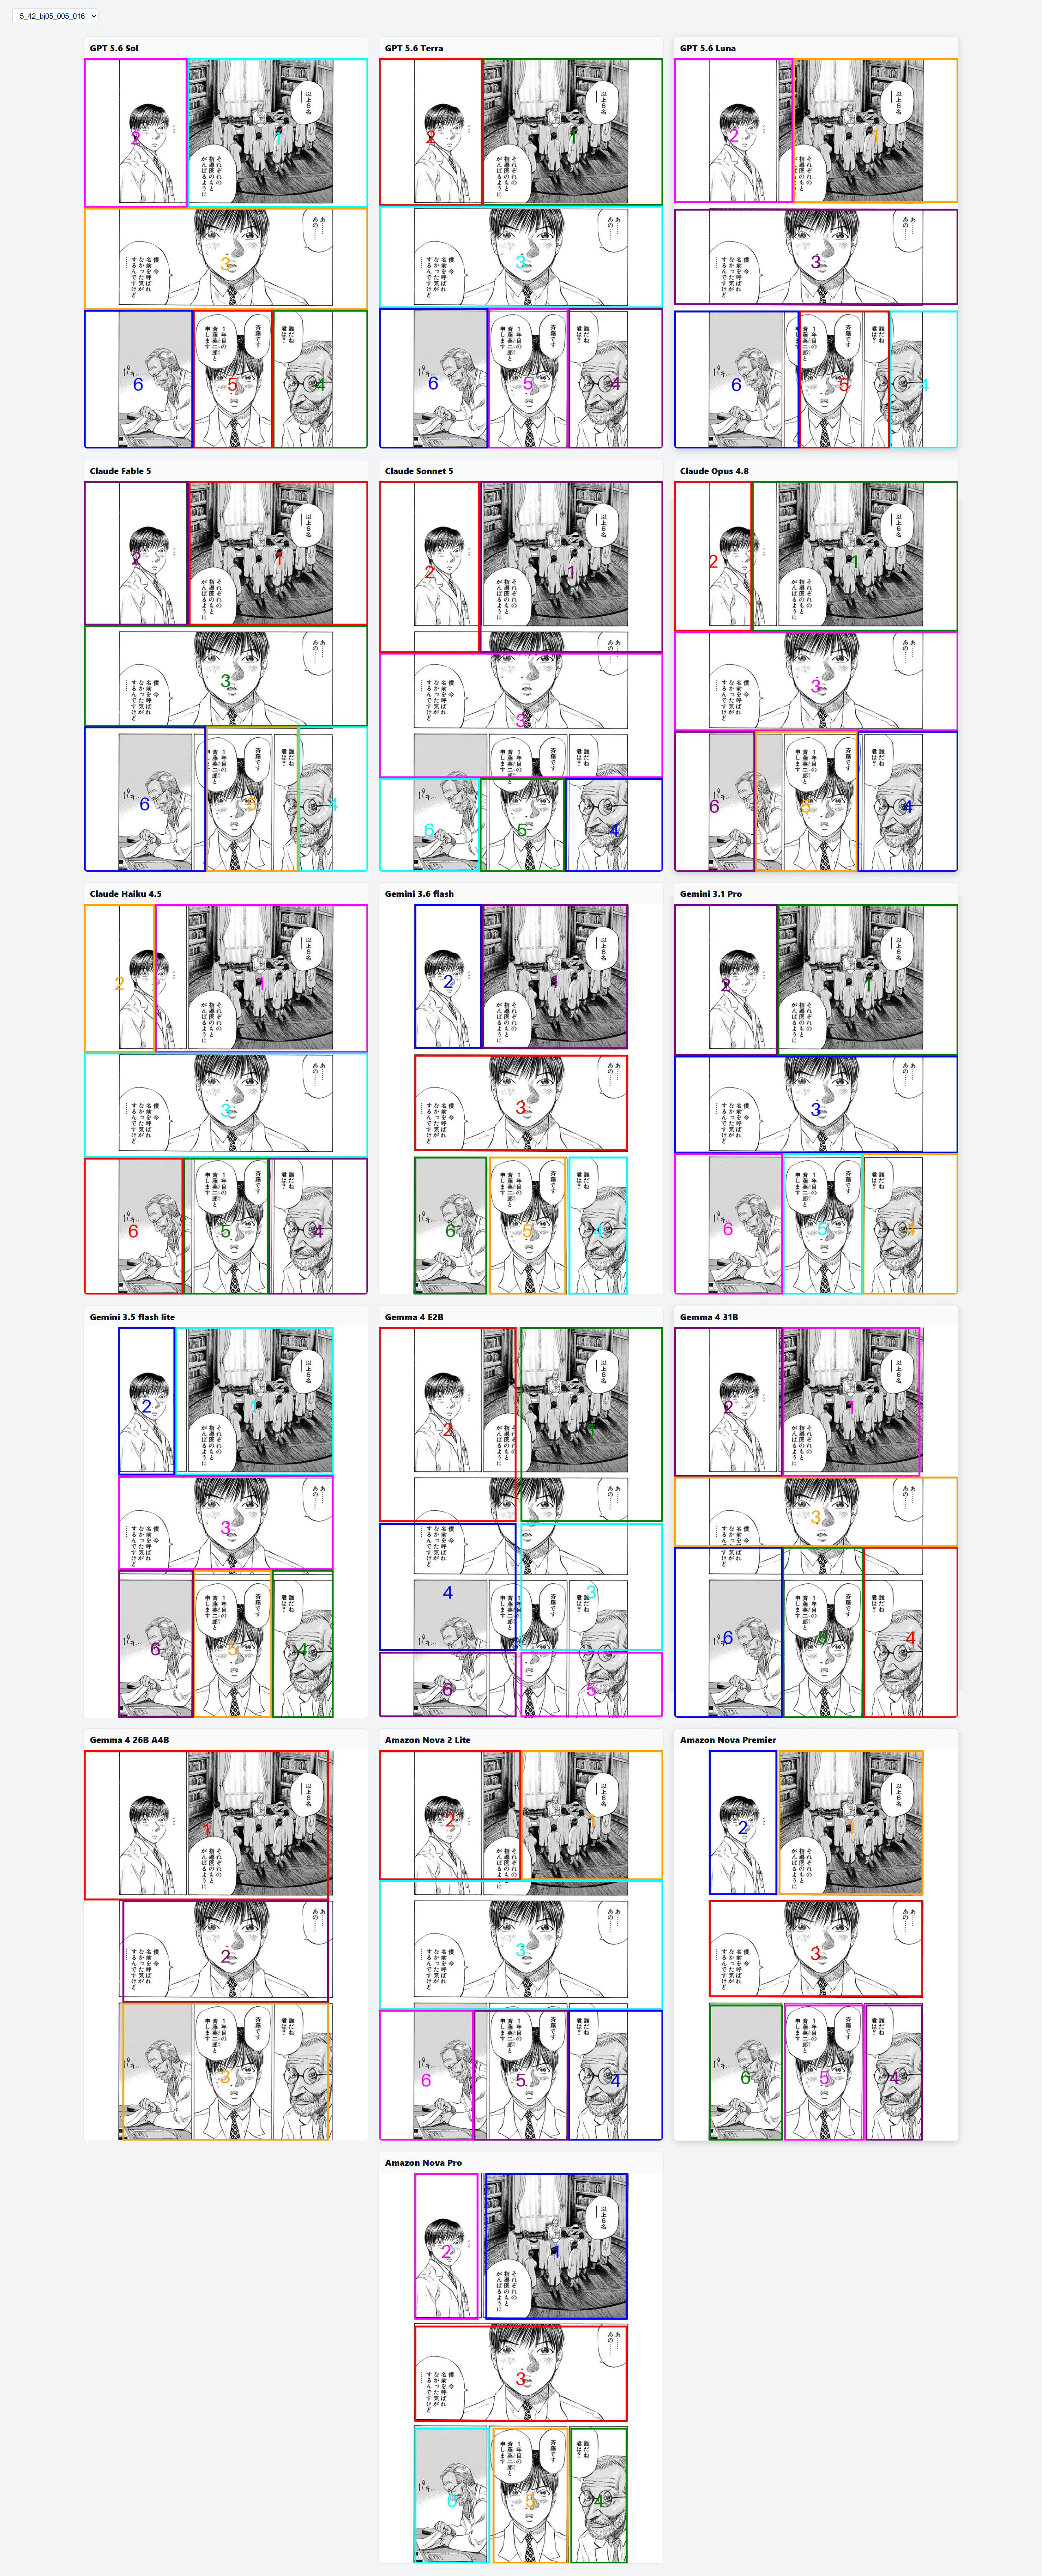
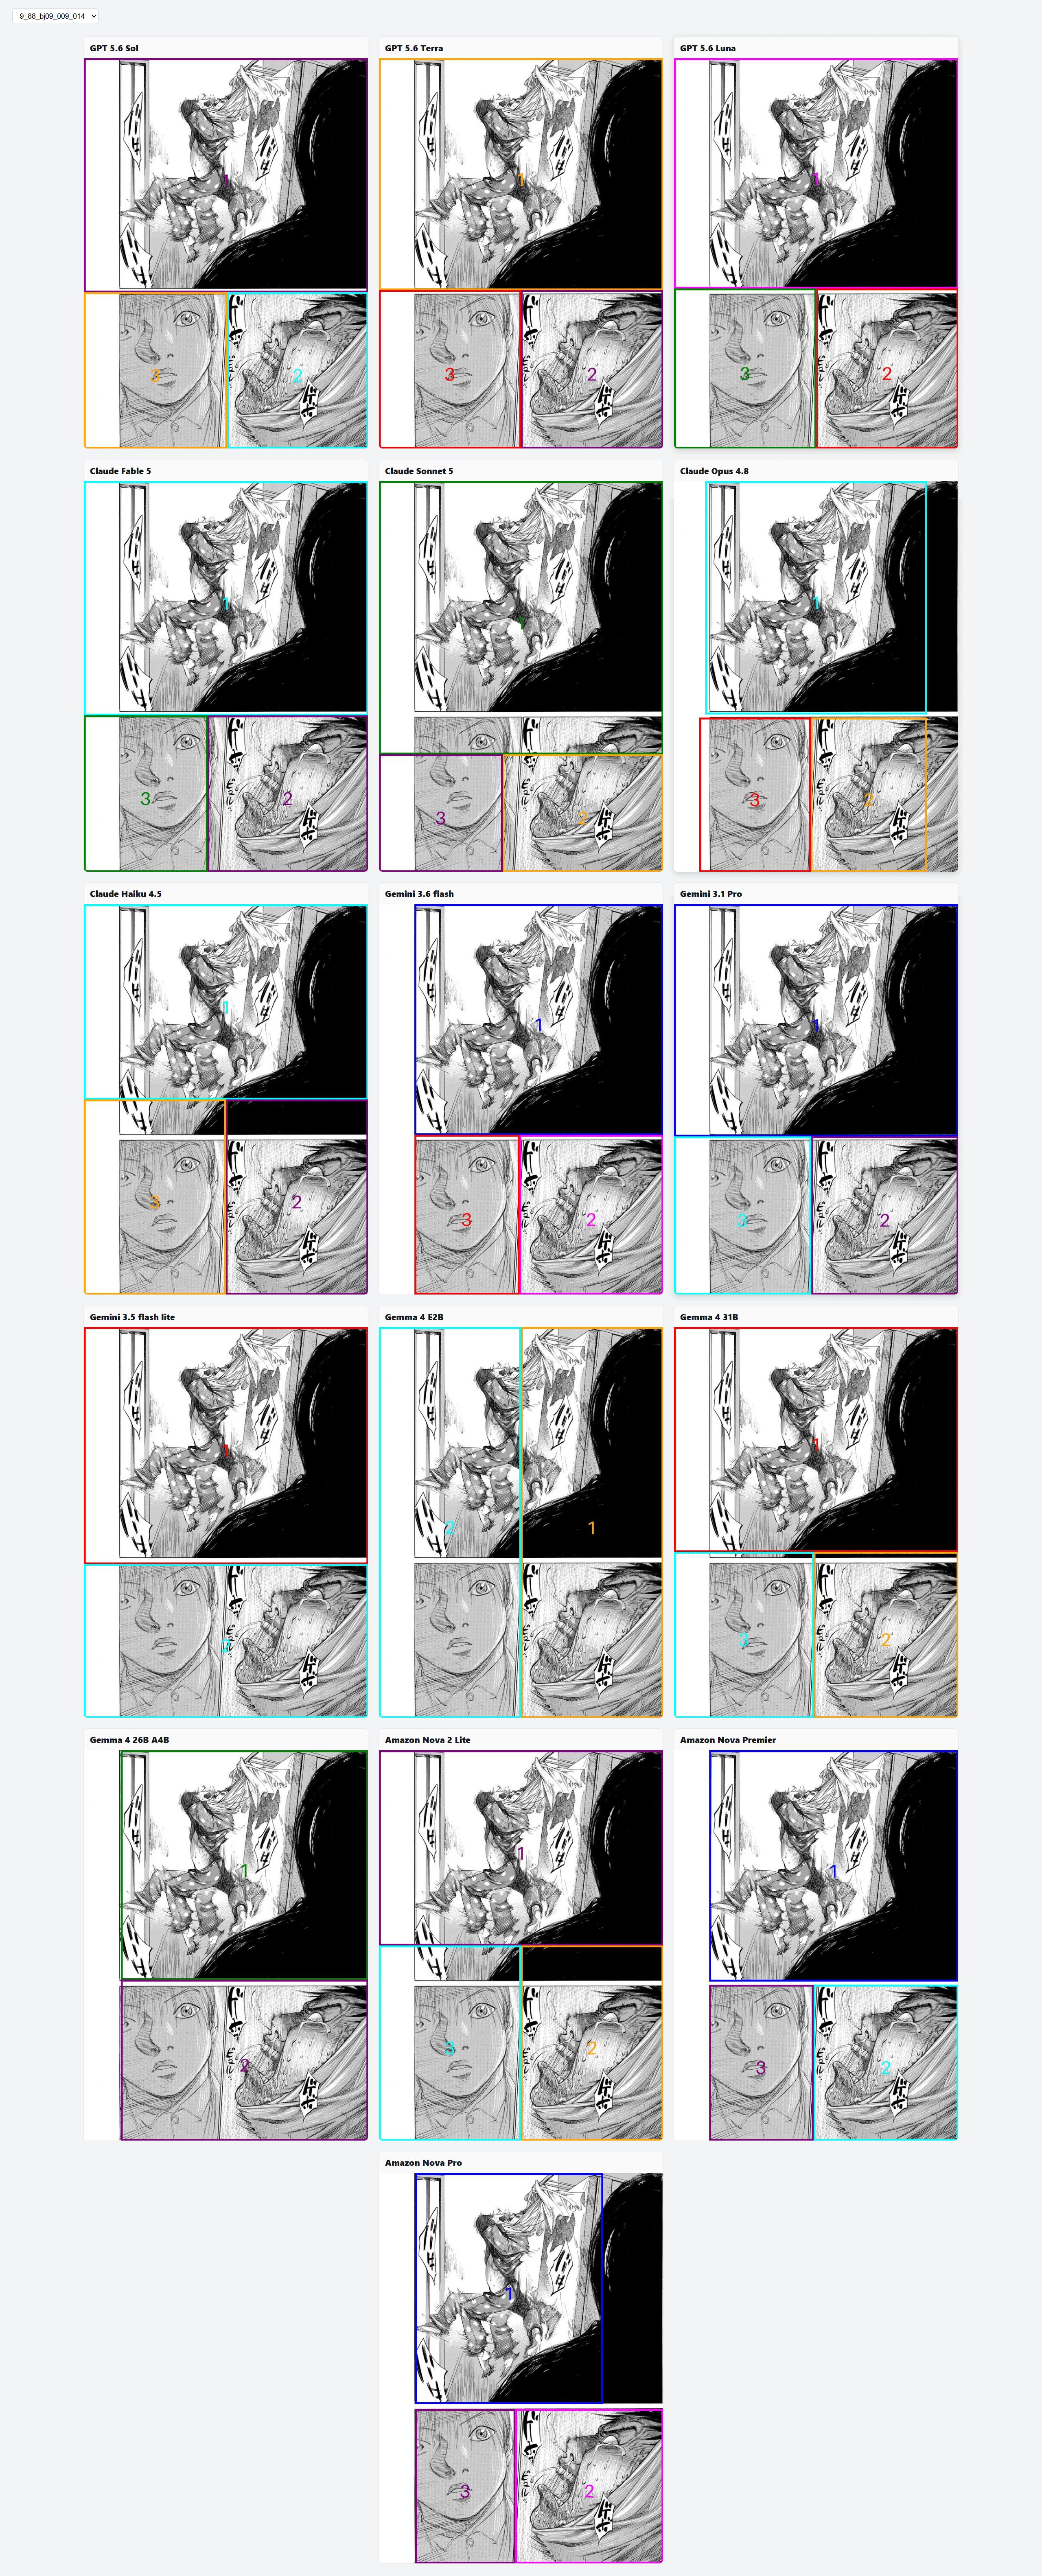
今回掲載している比較画像では、同じ漫画ページに対して複数のAIモデルでコマ解析を行い、それぞれが認識した領域を色付きの境界線で表示しています。
実際に比べると、一見すると同じページを認識できているようでも、モデルによって境界の位置や領域の分割方法がかなり異なることが分かります。比較画像にはGPT、Claude、Gemini、Amazon Nova系モデルなどの結果が並び、モデルごとに異なる領域分割と番号付けが発生しています。
この「人間には当たり前に見える漫画の構造」を安定して機械に理解させることが、漫画解析では非常に重要になります。
なぜNova Premierだったのか
これまでSTORYAIでは複数のマルチモーダルモデルを検証してきました。
しかし、漫画のコマ境界を認識させたとき、モデルによっては人物や吹き出しを境界として捉えてしまったり、隣り合ったコマをまとめてしまったり、逆に一つのコマを分割したりと、結果に大きな差がありました。
その中で、STORYAIの実運用条件を満たす結果を出せていたのがAmazon Nova Premierでした。
つまりSTORYAIにとってNova Premierは、「少し精度が高いモデル」というより、漫画解析パイプラインを成立させる重要な部品の一つでした。
だからこそ、モデルの終了は単純なAPIの差し替えでは済みません。
もう一度モデルを横並びで評価し、
「ページの構造を壊さず認識できるか」
「複雑なレイアウトでもコマを分離できるか」
「結果が継続的に安定するか」
という観点で移行先を探す必要がありました。
添付した検証結果でも、カラー原稿、人物や吹き出しが境界付近に存在するページ、線画主体で大きく黒ベタの入ったページなど、ページの性質によってモデルごとの差が現れています。
Gemini 3.6 Flashへの移行
今回の検証の結果、STORYAIではGemini 3.6 Flashへ移行することにしました。
Gemini 3.6 FlashはGoogleが現在提供しているGAモデルで、マルチモーダル処理に加えて空間推論を強みとするモデルです。
漫画のコマ認識では、「画像の中に何があるか」を答えられるだけでは不十分です。
重要なのは、
「画像のどこに、それが存在しているのか」
を理解できることです。 その意味で、今回の検証ではGemini 3.6 Flashの特性がSTORYAIの漫画解析と非常に相性のよい結果となりました。
もちろん、LLMやマルチモーダルモデルにはモデル固有の揺らぎがあります。
そのためSTORYAIでは「モデルが優秀だから、その出力をそのまま使う」という設計にはしていません。
ページ解析、コマ認識、その後の情報抽出までを一つのパイプラインとして設計し、モデル変更があってもサービス全体を安定させられることを重視しています。
今回のNova PremierからGemini 3.6 Flashへの移行も、その考え方を改めて検証する機会になりました。
生成AIの進化というと、文章生成や画像生成の性能が注目されがちです。
しかしSTORYAIが向き合っているのは、そのもう少し手前にある、
「AIは漫画というメディアそのものの構造を理解できるのか」
という問題でもあります。
漫画には、人間が長い時間をかけて身につけてきた独特の「読み方」があります。
コマ、視線、吹き出し、ページ、そして順番。
それらをAIがどこまで理解できるのか。
STORYAIでは今後も、漫画を単なる画像として処理するのではなく、漫画として理解するための技術を作っていきます。
今月末のアップデートでは、その一部を皆さんにも体験していただける予定です。
検証素材について
本記事および検証では、佐藤秀峰先生の 『ブラックジャックによろしく』 を使用しています。
貴重な作品データを二次利用可能な形で公開されている佐藤秀峰先生、ならびに佐藤漫画製作所の皆さまに心より感謝いたします。
本記事で使用している作品素材は、佐藤漫画製作所が公開する利用規約に基づいて使用しています。
作品名:ブラックジャックによろしく 著作者名:佐藤秀峰