

はじめに
ChatGPTは、業務効率を爆上げし、クリエイティブなアイデアをガンガン引き出す強力なツールです。
しかし、便利さの裏に「データの取り扱い」への不安も潜んでいます。
個人情報や機密ビジネスデータを扱う際には、慎重にその利用方法を考える必要があります。
そんなときに使えるのが、OpenAIが提供する「Do not train on my content」と「ChatGPT Personal Data Removal Request」というプライバシー保護機能です。この記事では、それぞれの機能のメリット・デメリットをわかりやすく解説し、さらにAPIを使う場合のデータ取り扱いについても触れていきます。
注記:この記事は2024年9月10日時点の情報に基づいています。OpenAIの方針が変更される可能性もありますので、最新情報は常に確認しましょう。
「Do not train on my content」 – 私のコンテンツを学習に使わないでください
「Do not train on my content」は、ChatGPTに提供したデータがAIモデルのトレーニングに使われないようリクエストできる機能です。
通常、ChatGPTは提供された情報を活用して自己改善していますが、この設定を使うと、あなたのデータが今後のモデルのトレーニングに使われなくなります。
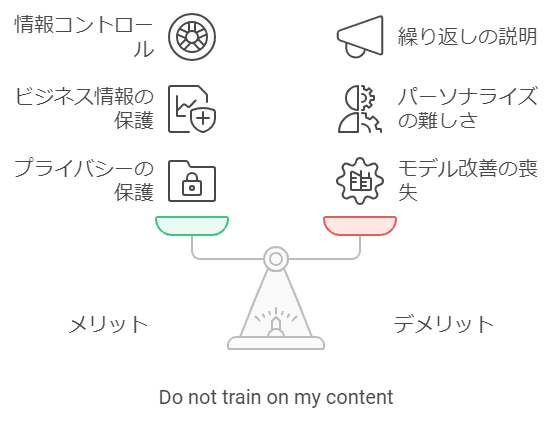
メリット
- プライバシーの徹底保護: 提供した個人情報や機密データがAI学習に使われないため、情報漏洩リスクを大幅に軽減します。
- ビジネス情報の保護: ビジネスで扱うセンシティブなデータが勝手に学習されるのを防ぎ、安心して利用できます。
- 情報コントロールの強化: 誤って入力した情報が将来のトレーニングデータに利用されることを防げます。
デメリット
- モデル改善に貢献できない: あなたの入力がモデル改善に使われないため、ChatGPTがより良いサービスになる機会を失ってしまいます。
- パーソナライズが難しい: 特定のニーズや専門情報を繰り返し入力しても、モデルがそれを学習しないため、同じ説明を何度も行う必要が出てくる可能性があります。
例えば、私たちが運営するSTORYAIのプロモーション業務では、ChatGPTにSTORYAIの機能や事例を読み込ませた上で、キャッチーなタグラインを考えたり、ブレインストーミングをしたりしています。このような用途では、ChatGPTが事前に提供されたデータを活用し、よりパーソナライズされた提案が行われます。
しかし、「Do not train on my content」を有効にすると、これらのデータが学習されなくなり、毎回同じ説明をしなければならず、提案の質も低下する可能性があります。
それでも、特にビジネス上のセンシティブな情報を扱う場面では、この設定を利用することで情報が無断で学習に使われるリスクを回避できます。
「Personal Data Removal Request」 – 個人データ削除リクエスト
「Personal Data Removal Request」は、ユーザーが過去にChatGPTに提供した個人情報を削除するようリクエストできる機能です。これにより、誤って入力した個人情報が利用されるリスクを軽減し、プライバシー保護を強化します。
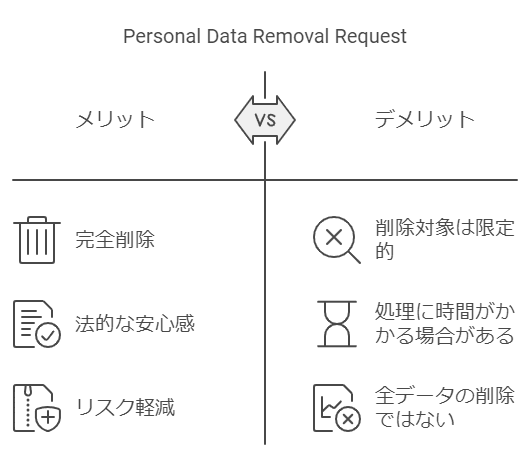
メリット
- 個人情報の完全削除: 以前に提供された個人情報が削除され、プライバシーリスクを大幅に軽減します。
- 法的な安心感: GDPRなどのプライバシー保護法に準拠して対応が取られるため、安心して利用できます。
- 過去のリスクの軽減: 過去の会話で誤って提供した個人情報も削除でき、後悔する前に対処できます。
デメリット
- 削除対象は限定的: 個人情報のみが削除されるため、ビジネス情報や他のセンシティブな内容は削除の対象外です。
- 処理に時間がかかる場合がある: 削除リクエストの処理には時間がかかる可能性があり、即座に解決されるとは限りません。
- 全データの削除ではない: 個人情報のみが削除されるため、それ以外のデータは引き続きトレーニングデータとして使用される可能性があります。
API利用時のデータ取り扱いについて
OpenAIの公式サイトによると、API経由でChatGPTを利用する場合、提供されたデータはモデルのトレーニングに使用されないことが明記されています。
これは、企業向けのChatGPT TeamやChatGPT Enterprise、APIプラットフォームを利用するビジネスユーザーにとって重要な情報です。
Services for businesses, such as ChatGPT Team, ChatGPT Enterprise, and our API Platform
We don’t use content from our business offerings such as ChatGPT Team, ChatGPT Enterprise, and our API Platform to train our models. Please see our Enterprise Privacy page for information on how we handle business data.
私たちが提供するSTORYAIでも、APIを利用してサービスを提供しています。API経由での利用では、提供されたデータが学習に使われないため、企業やプロジェクトで扱うセンシティブなデータの保護を心配する必要がありません。
この設定により、STORYAIを安心してご利用いただけます。
まとめ
ChatGPTを安全に、しかも効率的に活用するためには、プライバシーや機密情報の適切な管理が鍵を握っています。「Do not train on my content」や「Personal Data Removal Request」を賢く活用することで、データが不適切に利用されるリスクを減らせます。特に、APIを使ってChatGPTを利用する場合、データが学習に使用されないことが公式に保証されているので、ビジネスユーザーも安心です。
- プライバシー保護を最優先に考える方は、「Do not train on my content」をオンにして、データが勝手に学習に使われるリスクを防ぎましょう。
- サービスの向上やフィードバックを重視する方は、設定をよく検討し、最適なバランスを見つけることが大事です。
最後に、この情報は2024年9月10日時点のものであり、今後OpenAIの方針が変更される可能性があるため、最新情報の確認をお忘れなく!
※この記事で用いた図はNapkin AIで作成しました。